
AI vs Brush: Praktyczne Studium z semantyki wizualnej we wzorach powierzchniowych / surface pattern design
Ilustrator, klient i sztuczna inteligencja: dlaczego powstało to badanie
To badanie narodziło się nie z pytania abstrakcyjnego, lecz z wyzwania praktycznego. Wyłoniło się z bardzo realnej zmiany na rynku tekstyliów i wzorów powierzchniowych, ukształtowanej przez szybkie przyjęcie narzędzi sztucznej inteligencji przez klientów oraz konsumentów. Na początku 2024 roku, pracując jako ilustratorka komercyjna i projektantka wzorów powierzchniowych, otrzymałam od stałej klientki referencję wizualną. Natychmiast rozpoznałam, że obraz został wygenerowany przez model AI, mimo że został przedstawiony jedynie jako „inspiracja”, bez świadomości co do jego pochodzenia i konsekwencji. Był to moment symboliczny: sztuczna inteligencja pojawiła się w naszym procesie briefowania cicho, bez zapowiedzi, niesiona atrakcyjnością i szybkością nowych trendów obrazów generowanych przez AI, które przyciągały uwagę odbiorców końcowych.
Od tamtego momentu stało się jasne, że moja praca funkcjonuje już w nowym środowisku semantycznym — takim, które splata moją własną intencję artystyczną z oczekiwaniami rynku, interpretacją klientów dotyczącą nowych estetyk cyfrowych oraz z obrazami generowanymi maszynowo, wkraczającymi do rozmów o designie. Moim zadaniem było wtedy ręczne zaprojektowanie komercyjnego wzoru dziecięcego w stylu zbliżonym do referencji wygenerowanej przez AI. Niedługo później testowałam już różne narzędzia wspierane AI z klientami z branży mody, dekoracji wnętrz i szerzej — rynku tekstylnego. Niektórzy byli świadomi cyfrowej estetyki, lecz nie jej technologicznego źródła; inni wiedzieli dokładnie, skąd pochodzą obrazy, ale woleli powierzyć korzystanie z narzędzi AI profesjonaliście, któremu ufają. W każdym scenariuszu znalazłam się nagle w kontakcie ze sztuczną inteligencją w obszarze grafiki, bez obowiązujących wytycznych, zasad czy wspólnego rozumienia adekwatności wizualnej.

Statystyka kontra Intencja - jak AI widzi surface pattern design
To doświadczenie - komercyjne, dynamiczne, pełne nieoczekiwanych korzyści, ale też oczywistych ograniczeń - szybko doprowadziło mnie do prostego, a jednocześnie dalekosiężnego pytania: jak AI „widzi” moją pracę? I ważniejsze: czy słownik modelu pokrywa się z tym, co rzeczywiście tworzę? Wielokrotnie czułam, że mówimy różnymi językami. Co dzieje się z moją intencją estetyczną, stylem, techniką i kierunkiem narracji, gdy przechodzą przez przestrzeń embeddingów wytrenowaną na danych pozyskiwanych z internetu na masową skalę?
„AI vs Brush” powstało jako praktyczne dochodzenie w odpowiedzi na to właśnie pytanie. Projekt analizuje dziesięć zamówionych wzorów powierzchniowych zbudowanych na bazie referencji generowanych przez AI - łączących elementy malowane ręcznie z fragmentami wspomaganymi przez narzędzia algorytmiczne - i zestawia je z dziesięcioma wzorami zilustrowanymi w pełni manualnie, aby zobaczyć, jak model reaguje na szerokie spektrum twórczości.
Badanie koncentruje się na trzech warstwach znaczenia wizualnego:
• moich profesjonalnych tagach, ukształtowanych przez lata praktyki w ilustracji i surface pattern design;
• tagach opisowych generowanych przez bieżącą wersję OpenCLIP;
• oraz odległościach numerycznych w przestrzeni embeddingów, które pokazują, jak bardzo (lub jak słabo) te dwa słowniki znaczeń pokrywają się ze sobą.
Celem nie jest stwierdzenie, czy graficzna AI „działa dobrze” czy „źle”, choć raport zawiera krótką refleksję na ten temat. Sednem jest zrozumienie, jaki rodzaj znaczenia wizualnego przetrwa, a jaki zanika, kiedy praca artystyczna zostaje zinterpretowana przez model multimodalny.
Motywacją nie była krytyka, lecz potrzeba odzyskania klarowności semantycznej w czasie, gdy obrazy krążą pomiędzy interpretacją ludzką a maszynową. Proces twórczy przestał przebiegać linearnie. Zamiast tego tworzy pętlę, w której obrazy zamierzone przez człowieka i obrazy wygenerowane przez AI inspirują kolejne etapy pracy ludzkiej, które następnie ponownie trafiają do analizy maszynowej. Ta cyrkularność jest subtelna, lecz transformująca — i stanowi podstawę dla kluczowych tematów rozwijanych w całym raporcie.

Zwrot w semantyce wizualnej: od wczesnych testów do zaktualizowanego OpenCLIP
Kilka miesięcy przed wykonaniem pełnej analizy embeddingów przeprowadziłam serię wstępnych testów na wcześniejszych modelach opartych na CLIP. Testy te były niedoskonałe, lecz zaskakująco pouczające. Modele próbowały opisywać styl, medium oraz genealogie artystyczne. Często robiły to błędnie — momentami wręcz komicznie — lecz wykazywały przynajmniej szczątkową świadomość, że kultura wizualna zawiera kategorie takie jak „akwarela”, „malarstwo cyfrowe”, „szkic ołówkowy” czy nawet „barokowy portret”. Opisy były chaotyczne i niespójne, ale stanowiły próbę — choć niestabilną — wyjścia poza czysto powierzchowną percepcję.
Kiedy wróciłam do badania na początku 2026 roku, korzystając z aktualnej wersji OpenCLIP, zmiana była natychmiastowa i wyraźna. Model przestał próbować nazywać styl w ogóle. Kategorie historyczne, stylistyczne i techniczne całkowicie zniknęły, zastąpione o wiele mniejszym, komercyjnie dominującym słownictwem. Zamiast interpretacji stylu OpenCLIP stale generował opisy zorientowane na produkt, takie jak „pattern”, „wallpaper”, „seamless”, „storybook”, oraz — ze znacznie większą precyzją niż kilka miesięcy wcześniej — pojedyncze konkretne elementy typu „floral”, „owl”, „rose”. Przestrzeń opisowa zawęziła się, i to nie przypadkowo. Zbiegała się z internetową logiką kategorii wizualnych dominujących na marketplace’ach, w bankach zdjęć czy opisach zoptymalizowanych pod SEO. Wczesne etykiety stylu w CLIP — takie jak „watercolour painting”, „baroque style” — odzwierciedlały dystrybucję captionów w datasetach takich jak LAION-400M, gdzie treści tworzone przez artystów były bardziej obecne. Tendencja ta zanikła w późniejszych datasetach, w których dominowały opisy komercyjne.
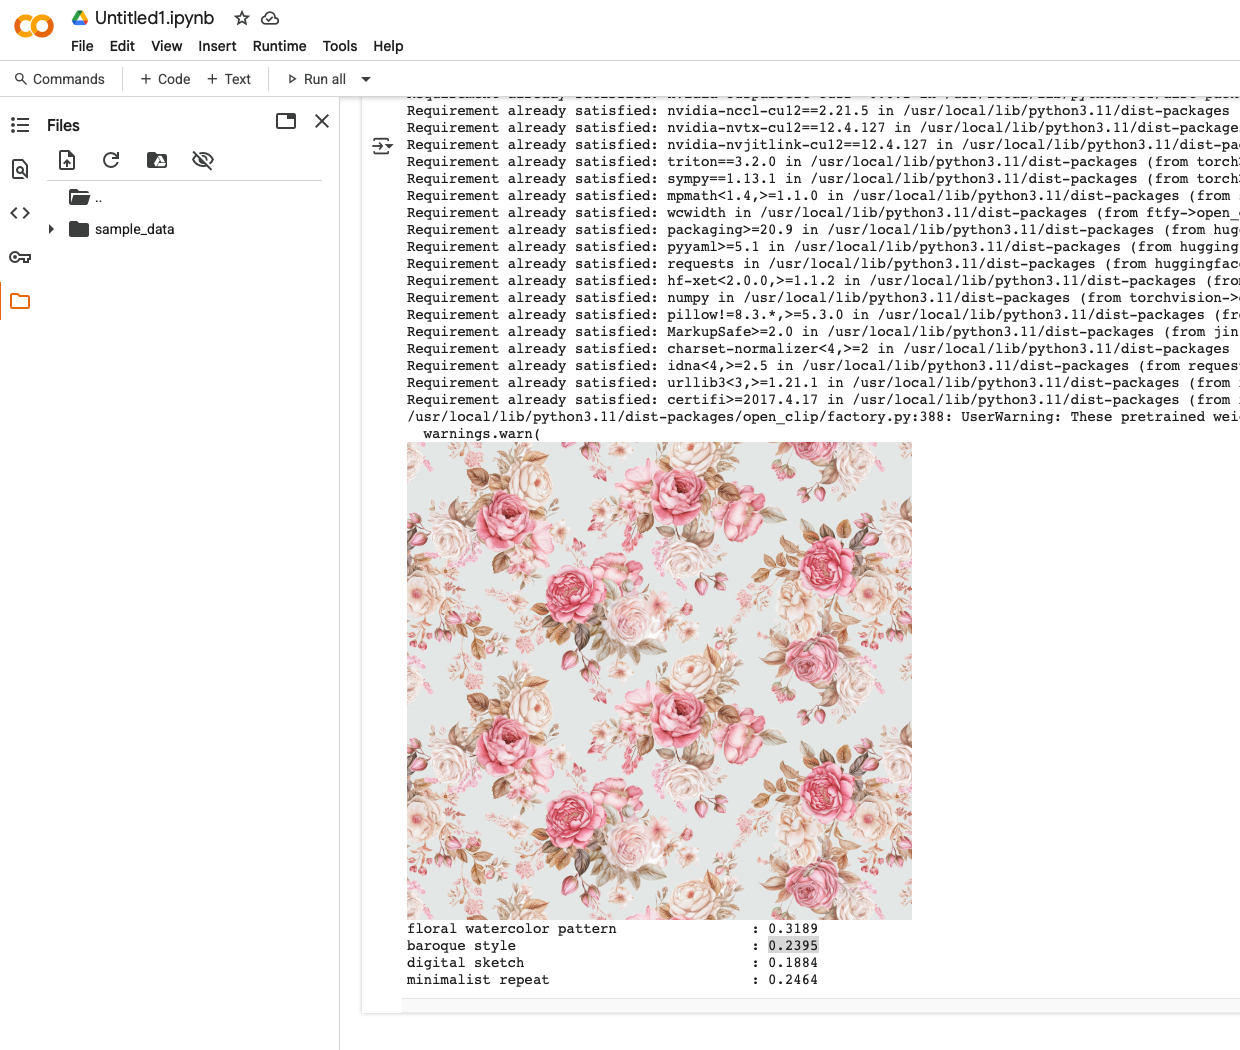
Ten zwrot można uznać za poprawę dokładności, lecz tylko w określonej logice: logice internetu, jego komercyjnych priorytetów i optymalizacji wyszukiwania. Ważniejsze jednak jest to, że sygnalizował on zmianę priorytetów semantycznych w modelu. Zaktualizowany OpenCLIP nie traktuje stylu ani techniki artystycznej jako kategorii o znaczeniu semantycznym. Zachowuje się tak, jakby styl nie miał „wagi” w jego przestrzeni reprezentacji.
Przystąpiłam do przeformułowania celu badań. Nie chodziło już tylko o porównywanie tagów ludzkich z tagami sztucznej inteligencji. Głównym pytaniem stało się: co oznacza dla modelu multimodalnego zaprzestanie rozpoznawania fundamentalnego elementu kultury wizualnej. Zniknięcie stylu ze słownika modelu nie było usterką techniczną, lecz symptomem kulturowym. Wskazało to na głębszy problem strukturalny: dryf semantyczny, w którym modele trenowane na wielkoskalowych danych internetowych stopniowo odchodzą od słownika sztuki w kierunku słownika komercyjnego wyglądu powierzchni.
Ta obserwacja ukierunkowała projektowanie analizy pełnego osadzenia. Jeśli język modelu ewoluuje w czasie – i to w sposób, który bezpośrednio wpływa na interpretację dzieł artystycznych – to badanie musi nie tylko mierzyć zgodność semantyczną, ale także badać mechanizmy kształtujące światopogląd modelu. Kolejne sekcje przechodzą od tych obserwacji empirycznych do szerszych ram konceptualnych, opisując rekurencyjną relację między sztuczną inteligencją, ludzką praktyką twórczą i środowiskami internetowymi, które w coraz większym stopniu pośredniczą w obu tych aspektach.
Wczesne oznaki Echa Semantycznego
W miarę jak uwidaczniały się różnice między wcześniejszymi testami na CLIP a wynikami OpenCLIP, stawało się jasne, że zachowanie modelu zmieniło się nie tylko technicznie, lecz koncepcyjnie. Zniknięcie stylu było zbyt konsekwentne, by je ignorować. Model nie rozwijał już swojej przestrzeni interpretacyjnej — raczej się w nią zawijał. To, co początkowo wyglądało na poprawę precyzji, zaczęło przypominać coś innego: echo jego własnych, uprzednio nauczonych kategorii.
Na tym etapie pojęcie Echa Semantycznego funkcjonowało jako hipoteza robocza. Zakładało, że model nie tylko uczy się z internetu, lecz również z outputów wcześniejszych modeli, które zaczynają krążyć online. Jeśli obrazy generowane przez AI trafiają do datasetów, z których korzystają kolejne generacje modeli, język opisowy staje się odzwierciedleniem nie tylko ludzkich konwencji, ale i tendencji wcześniejszych systemów AI, gdzie znaczenie nie rozszerza się, a rezonuje.
Wraz z postępem badania hipoteza ta nabierała sensu. W każdym obrazie, w każdym klastrze tagów, w każdej obliczonej odległości w embeddingach powtarzał się ten sam wzorzec: model traktował pewne kategorie jak punkty grawitacji semantycznej. Komercyjne etykiety były stabilne, podczas gdy stylistyczne zanikały. Ten wczesny wgląd stał się fundamentem części koncepcyjnej raportu, rozwijanej w kolejnych sekcjach.
Metodologia: analiza semantyki wizualnej w podejściu praktycznym
Struktura metodologiczna niniejszego badania została ukształtowana przez praktyczny kontekst, z którego się wyłoniło. W przeciwieństwie do tradycyjnych studiów nad modelami multimodalnymi, które zaczynają się od z góry zaprojektowanych zbiorów danych, „AI vs Brush” opiera się na rzeczywistych zamówieniach, rzeczywistych wymaganiach klientów i rzeczywistych procesach projektowych. Punktami wyjścia były wzory powierzchniowe tworzone na potrzeby branży tekstylnej, mody i dekoracji wnętrz, a więc w środowisku, w którym obrazy generowane przez AI zaczęły pojawiać się organicznie — nie jako eksperyment, lecz jako część codziennej praktyki.
Badanie obejmuje dwadzieścia wzorów podzielonych na dwie grupy. Pierwsza grupa to dziesięć projektów stworzonych na podstawie referencji wygenerowanych przez modele AI, łączących elementy malowane ręcznie z fragmentami powstałymi w narzędziach generatywnych. Druga grupa to dziesięć wzorów zilustrowanych w pełni manualnie, od pierwszego szkicu aż po finalną kompozycję. Ten dualny układ pozwala porównać, jak model multimodalny interpretuje obrazy powstałe w różnych warunkach twórczych: tych częściowo zależnych od maszyn oraz tych całkowicie zakorzenionych w ludzkiej praktyce ilustracyjnej.
Każdy wzór został dwukrotnie opisany. Najpierw przy użyciu profesjonalnych tagów wynikających z wieloletniej praktyki projektowania wzorów powierzchniowych, a następnie za pomocą tagów generowanych przez model OpenCLIP. Zestawienie tych dwóch metod opisu umożliwiło zbadanie trzech warstw znaczenia:
- techniki (jak projekt został wykonany),
- efektu wizualnego (jak wygląda na poziomie percepcji)
- oraz intencji estetycznej (jakie znaczenie miał nieść w odbiorze).
Oddzielenie tych trzech kategorii pozwala uchwycić złożoność procesu twórczego, którego modele multimodalne nie są w stanie samodzielnie odwzorować.

Porównanie tagów manualnych i embeddingów OpenCLIP w projektowaniu wzorów powierzchniowych
Podstawą ram metodologicznych tego badania jest analiza osadzania znaczeń. Każdy tag, zarówno generowany przez człowieka, jak i przez sztuczną inteligencję, jest reprezentowany jako wielowymiarowy wektor we wspólnej przestrzeni semantycznej OpenCLIP. Badanie analizuje odległości między tymi wektorami, aby zmierzyć zgodność, tarcie i rozbieżność między znaczeniem ludzkim a znaczeniem maszynowym. Odległości te ujawniają nie tylko, jak model rozpoznaje wzorce w projektowaniu wzorców powierzchniowych, ale także, jak jego przestrzeń interpretacyjna ewoluuje w różnych punktach kontrolnych uczenia. Łącząc rzeczywiste praktyki komercyjne z analizą obliczeniową, metodologia uchwyca zarówno warstwę artystyczną, jak i algorytmiczną, które kształtują dzisiejszą interpretację wizualną.
Część zbioru danych składa się z projektów hybrydowych wygenerowanych przy użyciu Adobe Express. Wybrałem to narzędzie celowo. Spośród obecnie dostępnych platform generatywnych, Adobe Express jest najbardziej zbliżony do środowiska oprogramowania używanego przez profesjonalnych ilustratorów i projektantów wzorów powierzchni. Jako osoba pracująca na co dzień w programach Adobe Photoshop i Illustrator, istotne było dla mnie zbadanie materiałów generowanych przez sztuczną inteligencję, pochodzących z tego samego ekosystemu kreatywnego.
Generowane dane wyjściowe z Adobe Express ujawniły powtarzający się wzorzec, który stał się istotny metodologicznie. Pomimo wyraźnych monitów o powtarzalne, gotowe do użycia jako kafelki kompozycje, system nigdy nie wygenerował prawdziwie jednolitego kafelka. Każdy wynik wygenerowany przez sztuczną inteligencję wymagał rozległego postprodukcji: ręcznej rekonstrukcji struktur powtórzeń, korekty błędów perspektywy lub ciągłości oraz naprawy wizualnie nieprawdopodobnych artefaktów, które bez wątpienia zostały stworzone przez maszynę, a nie przez człowieka. Generator mógł generować interesujące wizualne punkty wyjścia, ale nie był w stanie dostarczyć materiału gotowego do produkcji. Każdy wzór hybrydowy odzwierciedla zatem warstwowy proces pracy, w którym sztuczna inteligencja dostarcza surowe fragmenty wizualne, a projektant pozostaje odpowiedzialny za spójność techniczną, dopracowanie stylistyczne i wykonalność funkcjonalną ostatecznego wzoru powierzchni.
Te obserwacje wpłynęły na decyzję metodologiczną o traktowaniu zbioru danych jako spektrum, a nie binarnego. Zamiast dzielić prace na „ręczne” i „wspomagane sztuczną inteligencją”, badanie analizuje, jak zmieniają się znaczenia w zależności od stopnia zaangażowania maszyn – i jak model multimodalny interpretuje te zmiany lub w ogóle ich nie interpretuje.
Jak sztuczna inteligencja odczytuje ilustracje: cechy wizualne kryjące się za embeddingami OpenCLIP
Zrozumienie, co analizują modele sztucznej inteligencji podczas przekształcania dzieła sztuki w osadzenie numeryczne, jest kluczowe dla interpretacji semantycznych wyników tego badania. Wbrew powszechnemu przekonaniu, że sztuczna inteligencja rozpoznaje styl artystyczny lub intencje twórcze, modele multimodalne, takie jak CLIP i OpenCLIP, działają na zasadniczo innej warstwie znaczenia wizualnego. Uczą się one poprzez dopasowywanie cech obrazu do napisów w języku naturalnym zebranych na skalę internetową, a nie poprzez zrozumienie techniki artystycznej lub dziedzictwa estetycznego.
Wiemy, na jakie kryteria wizualne zwracają uwagę te modele, dzięki czterem uzupełniającym się źródłom: architekturze Vision Transformers, wizualizacjom map cech, które ujawniają wewnętrzne wzorce uwagi modelu, udokumentowanym celom szkoleniowym systemów opartych na CLIP oraz rosnącej liczbie badań analizujących multimodalne przestrzenie osadzania (Radford i in., 2021; Jia i in., 2021).
W praktyce oznacza to, że CLIP uczy się podkreślać atrybuty wizualne, które najsilniej współwystępują z typowymi opisami online – przede wszystkim obiekty, tekstury, kolory i układ przestrzenny – a nie jakiekolwiek właściwości wysokiego poziomu związane ze stylem, medium czy techniką. Jak podsumowano w najnowszych badaniach, „multimodalne modele osadzania oparte na CLIP są trenowane poprzez dopasowywanie cech obrazu do napisów w języku naturalnym znalezionych online, ucząc się atrybutów wizualnych, takich jak obiekty, tekstury, kolory i układ przestrzenny, które silnie korelują z opisami tekstowymi, ale bez mechanizmu uchwycenia wysokiego poziomu stylu artystycznego lub techniki”. (na podstawie Radford i in., 2021; Jia i in., 2021)
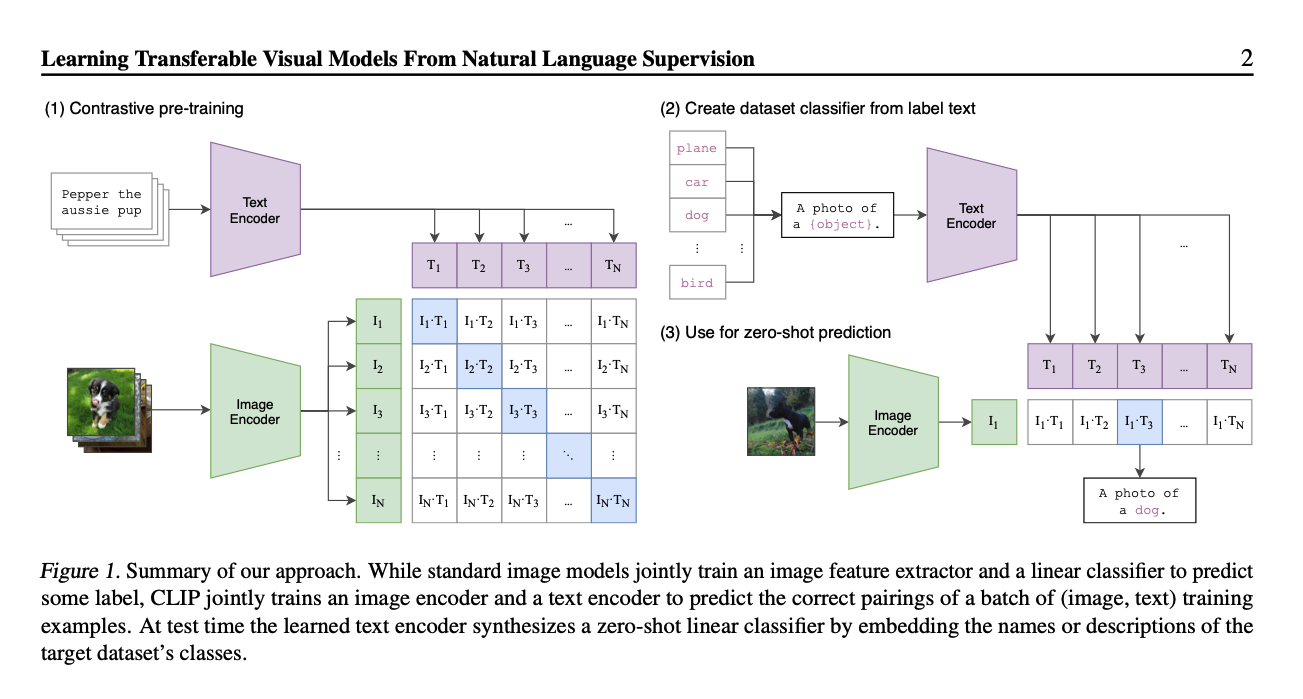
Radford et al., 2021; Jia et al., 2021
Prowadzi to do ważnego wniosku dla badań nad sztukami wizualnymi: multimodalne modele osadzania nie uczą się abstrakcyjnego pojęcia stylu artystycznego. Uczą się częstych, opisowych cech wizualnych, które pojawiają się w obszernych napisach internetowych – a nie procesów, gestów czy historii, które definiują praktykę artystyczną. Z metodologicznego punktu widzenia wyjaśnia to, dlaczego model w tym badaniu jest niezwykle spójny w identyfikacji kwiatów, struktur tła czy gęstości ornamentalnej, a jednocześnie konsekwentnie nie rozpoznaje techniki akwareli, pociągnięć pędzlem, mediów hybrydowych ani intencji estetycznej. Przestrzeń osadzania koduje sygnały na poziomie powierzchniowym, ale język modelu nie jest w stanie wyrazić znaczenia pracy artystycznej.
Prawdopodobnym wyjaśnieniem zaniku słownictwa stylistycznego w nowszych wersjach OpenCLIP nie jest zmiana architektury modelu, lecz ewolucja danych, na których trenowane są te systemy. Wczesne modele CLIP (2021) często próbowały etykietować styl – choć niekonsekwentnie – ponieważ dostępne wówczas internetowe zbiory danych zawierały większy odsetek treści generowanych przez artystów, w tym podpisy odnoszące się do „ilustracji akwarelowej”, „malarstwa barokowego”, „portretu olejnego” i podobnych terminów zakorzenionych kulturowo. Między 2023 a 2026 rokiem krajobraz obrazów online zmienił się diametralnie: internet zalały obrazy generowane przez sztuczną inteligencję, platformy stockowe przestawiły się na deskryptory produktów zoptymalizowane pod kątem SEO, a duże zbiory danych coraz częściej odzwierciedlały język komercyjny, a nie artystyczny. Można zatem zasadnie założyć, że zmieniające się słownictwo modelu nie jest oznaką zmniejszonych możliwości, lecz konsekwencją zmieniającego się środowiska językowego, z którego się uczy. Wraz ze zmianą rozmieszczenia podpisów zmienia się również przestrzeń semantyczna modelu — faworyzując kategorie produktów kosztem kategorii stylistycznych i historycznych.

Dane: dwadzieścia wzorów i dwie rzeczywistości twórcze
Zbiór danych wykorzystany w badaniu odzwierciedla dwoistą naturę współczesnej praktyki projektowej, w której dzieła sztuki stworzone przez człowieka współistnieją z obrazami wspomaganymi przez sztuczną inteligencję. Pierwsza połowa zbioru danych składa się z dziesięciu zleconych projektów wzorów powierzchni, stworzonych bezpośrednio w odpowiedzi na referencje klientów wygenerowane przez sztuczną inteligencję. Obrazy te często niosą ze sobą charakterystyczny ton graficznej sztucznej inteligencji, z jej estetycznymi skrótami, cyfrowo płynną logiką wizualną i tendencją do sprowadzania tradycji stylistycznych do uproszczonych form dekoracyjnych. Projektowanie w oparciu o te odniesienia wymagało znalezienia równowagi między poszanowaniem oczekiwań komercyjnych a przywróceniem spójności artystycznej.
Druga część zbioru danych przedstawia dziesięć ręcznie zilustrowanych wzorców, z których każdy opiera się na odrębnej intencji artystycznej, a nie na podpowiedziach sztucznej inteligencji. Prace te stanowią przeciwwagę dla wzorców inspirowanych sztuczną inteligencją, oferując wgląd w to, jak model zachowuje się w konfrontacji z obrazami ukształtowanymi wyłącznie przez ludzką intuicję, technikę i wrażliwość stylistyczną. Razem, obie grupy tworzą kompleksowy obraz interakcji sztucznej inteligencji i ludzkiej kreatywności w szerszym kontekście projektowania wzorów powierzchniowych.
Każdemu projektowi towarzyszą metadane: profesjonalne tagi opisujące technikę, kierunek estetyczny i zamierzoną narrację, a także tagi wygenerowane przez OpenCLIP, które reprezentują interpretację modelu. Zbiór danych zawiera również numeryczne wektory osadzania dla każdego tagu, umożliwiające obliczenie odległości, które pokazują, jak znaczenie zmienia się w przestrzeni multimodalnej. Dzięki wykorzystaniu zarówno wzorców zleconych, jak i autorskich, zbiór danych odzwierciedla rzeczywistość projektowania w erze, w której sztuczna inteligencja aktywnie kształtuje oczekiwania klientów i szeroko pojętą kulturę wizualną.

Dzięki pracy zarówno z wzorcami zleconymi, jak i autorskimi, zbiór danych odzwierciedla rzeczywistość projektowania w erze, w której sztuczna inteligencja aktywnie kształtuje oczekiwania klientów i szeroko pojętą kulturę wizualną. Celowo wybrałem tę mieszankę wzorców, aby zaobserwować, jak model odczytuje dwa rodzaje stylistycznych źródeł: moje „czyste”, w pełni ręczne, artystyczne, akwarelowe tekstury, pociągnięcia pędzlem i pomysłowe kompozycje oparte na postaciach – oraz „czyste” pismo odręczne AI generowane niemal w całości za pomocą Adobe Express, sporadycznie mieszane z elementami malowanymi ręcznie. Moim celem było sprawdzenie, czy OpenCLIP będzie w stanie rozróżnić te różne formy autorstwa, zwłaszcza że graficzny „pędzel” AI stał się bardzo rozpoznawalny dla profesjonalnych projektantów. Co zaskakujące, model całkowicie zignorował to rozróżnienie. Traktował oba stylistyczne źródła jako semantycznie równoważne, co rodzi ważne pytanie: dlaczego model multimodalny zaciera różnicę między ludzką techniką artystyczną a charakterystyczną wizualną sygnaturą obrazów generowanych przez AI?
Wyniki: tagi, embeddingi i zgodność pomiędzy znaczeniem ludzkim a maszynowym
Wyniki badania ujawniają spójny i znaczący wzorzec w sposobie, w jaki OpenCLIP interpretuje wzory powierzchni. Analizując wygenerowane tagi dla wszystkich dwudziestu wzorów, model wykazuje silną preferencję dla deskryptorów komercyjnych. Słowa takie jak „wzór”, „tapeta”, „bezszwowy”, „kwiatowy” i „książka z opowiadaniami” pojawiają się z dużą częstotliwością, tworząc wąskie pole rozpoznania skoncentrowane na funkcji dekoracyjnej, a nie na tożsamości stylistycznej czy zastosowanej technice: „ilustracja akwarelowa”, „ilustracja cyfrowa”. Z kolei tagi profesjonalne koncentrują się wokół intencji estetycznej, techniki i kierunku artystycznego, tworząc słownictwo ukształtowane przez lata praktyki w projektowaniu ilustrowanym i tekstylnym.
Analiza osadzania wzmacnia ten kontrast. Odległości między profesjonalnymi tagami często odzwierciedlają naturalne zróżnicowanie w obrębie intencji artystycznej, zakorzenione w konkretnych narracjach lub stworzone za pomocą odrębnych technik. Tymczasem odległości między tagami generowanymi przez sztuczną inteligencję ujawniają model, którego przestrzeń interpretacyjna jest ustabilizowana wokół kategorii komercyjnych. Im bardziej model ewoluował, tym bardziej jego słownictwo zbliżało się do tego samego, zwartego zestawu etykiet.
Tarcie semantyczne między manualnymi opisami pattern design i opisami AI
Porównując centroidy tagów profesjonalnych i generowanych przez sztuczną inteligencję, widoczne staje się tarcie semantyczne. W kilku projektach interpretacja modelu wydaje się koncentrować wokół funkcji dekoracyjnej, a nie zamierzonego stylu. Nawet w projektach autorskich, gdzie styl jest kluczowy dla kompozycji, OpenCLIP w przeważającej mierze redukuje znaczenie do deskryptorów powierzchownych. To zachowanie pozostaje spójne w obu grupach wzorców, co sugeruje, że model nie reaguje inaczej na obrazy stworzone przez człowieka lub inspirowane przez sztuczną inteligencję. Zamiast tego reaguje na statystyczną grawitację danych treningowych.
Wyniki te stanowią podstawę dalszej analizy koncepcyjnej. Pokazują one nie tylko to, co model widzi, ale także to, czego nie widzi: niuanse stylistyczne, wielowarstwową intencję estetyczną i spójność narracji, które definiują projektowanie wzorów powierzchniowych jako dziedzinę kreatywną. W kolejnych sekcjach zbadamy, dlaczego ta luka istnieje i jak rekurencyjna relacja między sztuczną inteligencją a danymi trenowanymi w internecie wzmacnia ją z czasem.

Case Study: jak AI interpretuje wzory powierzchniowe w praktyce
Poniższe studia przypadków ilustrują, jak luka semantyczna zidentyfikowana w analizie osadzania przejawia się w rzeczywistej praktyce projektowania wzorów powierzchniowych. Przyglądając się uważnie poszczególnym projektom, możemy zaobserwować, jak multimodalny model sztucznej inteligencji interpretuje zamysł artystyczny, niuanse stylistyczne i techniki hybrydowe – i gdzie jego interpretacje najwyraźniej odbiegają od ludzkiego znaczenia.
Case Study 1 — Photo Peony (ai-vs-brush_17)
Najwyższy wynik tarcia semantycznego: 0,271
Technika: Fotografia, malarstwo cyfrowe, postprodukcja w programie Photoshop
Efekt wizualny: hybrydowy wygląd fotografii cyfrowej
Krótki opis: Projekt opracowany w programie Photoshop z wykorzystaniem autorskich elementów tekstury fotograficznej i autorskiej ilustracji cyfrowej.
Spośród wszystkich dwudziestu projektów, Photo Peony uzyskał najwyższy wynik tarcia semantycznego w zbiorze danych. Wzór łączy fotograficzne fragmenty piwonii z malarskim przemalowaniem – hybrydową techniką, która łączy realizm, artystyczną interwencję i logikę druku komercyjnego. Moje profesjonalne tagi podkreślały tę hybrydowość: fotograficzne podłoże i cyfrowe przemalowanie. Intencją stojącą za tą pracą było połączenie dwóch tradycji wizualnych w spójny gest artystyczny.
OpenCLIP zinterpretował jednak dzieło niemal wyłącznie przez pryzmat komercyjny. Dominujące tagi modelu: „pastelowe tło kwiatowe”, „tło róż” i podobne – pozbawiły projekt jego hybrydowej tożsamości i sprowadziły go do tego samego skupiska semantycznego, co czysto dekoracyjna grafika powierzchniowa. W słowniku modelu nie ujawniła się ani fotograficzna tekstura, ani cyfrowo-malarska integracja, ani stylistyczna intencja. Odległości między elementami ujawniają szeroką lukę semantyczną między interpretacjami ludzkimi i maszynowymi, potwierdzając, że modelowi brakuje osi reprezentacyjnych zdolnych do wyrażenia samej hybrydowości.
Photo Peony pokazuje, jak multimodalna sztuczna inteligencja obsługuje mieszane źródła wizualne: nie robi tego. Redukuje złożoność konstrukcji estetycznej do najczęściej występujących deskryptorów komercyjnych dostępnych w danych treningowych. Ten przypadek ilustruje szerszy schemat: im bardziej celowe pod względem stylistycznym lub technicznie wielowarstwowe staje się dzieło sztuki, tym bardziej agresywnie model je spłaszcza.
Case Study 2 — Beehive (ai-vs-brush_10)
Najwyższy wynik tarcia semantycznego: 0.256
Technika: Ilustracja akwarelowa, postprodukcja w Photoshopie
Efekt wizualny: Ilustracja akwarelowa
Krótki opis: Projekt łączący tradycyjne ilustracje akwarelowe na papierze z inspiracją cyfrową.
Beehive reprezentuje grupę ręcznie tworzonych, autorskich wzorów w zbiorze danych. Jego konstrukcja opiera się na delikatnych fakturach akwareli, organicznej grafice liniowej i rytmie kompozycyjnym typowym dla ilustrowanych wzorów powierzchni dla dzieci. Moje profesjonalne tagi podkreślały narracyjną intencję, rękodzieło i tradycyjną pracę akwarelową.
Odczyt OpenCLIP był niemal odwrotny do tej logiki. Model identyfikował podstawowe elementy: pszczoła, miód, ale ponownie domyślnie używał wąskiego pasma etykiet, takich jak „wnętrza ula”. Analiza osadzania pokazuje silny dryf w kierunku tego samego centrum komercyjno-opisowego widocznego w całym zbiorze danych, przy czym odległości wskazują na minimalną wrażliwość na intencję stylistyczną. Model rozpoznaje obiekty, ale nie ramy artystyczne, które je kształtują.
To, co czyni Beehive szczególnie wymownym, to fakt, że nie jest to obraz wygenerowany przez sztuczną inteligencję. Oznacza to, że utraty semantyki nie można przypisać mieszanemu autorstwu. Nawet w najbardziej klarownych przykładach techniki stworzonej przez człowieka, OpenCLIP sprowadza znaczenie do kategorii komercyjnych. Model traktuje ilustrację akwarelową jako nieodróżnialną od masowego druku dekoracyjnego, co dowodzi, że niuanse stylistyczne istnieją poza jej zakresem reprezentacyjnym.

Case Study 3 — Digital Meadow (ai-vs-brush_07)
Najwyższy wynik tarcia semantycznego: 0.245
Technika: Adobe Express + postprodukcja w Photoshopie
Efekt wizualny: styl ilustracji cyfrowej
Krótki opis: Projekt o wyraźnie cyfrowym wyglądzie, inspirowany sztuczną inteligencją, opracowany przy użyciu programu Adobe Express i z ręczną korektą.
Digital Meadow to w pełni hybrydowy wzór stworzony bezpośrednio w programie Adobe Express, specjalnie dobrany do analizy interpretacji przez model „czystej”, rozpoznawalnej estetyki pędzla AI. Wzór wykazuje typowe cechy generowane przez AI: nadmiernie gładkie kontury, jednorodne cieniowanie, powtarzalne formy botaniczne i wyraźną cyfrowo-płaską tonalność. Moje profesjonalne tagi uwypukliły tę sztuczną gładkość, niezwykłą spójność kształtów i konieczność ręcznych interwencji w celu korekcji artefaktów wizualnych.
Interpretacja OpenCLIP całkowicie zatarła to rozróżnienie. Pomimo wyraźnie syntetycznego charakteru wzoru, modelowi przypisano to samo wąskie słownictwo: „bezszwowy wzór tkaniny 8k”, „kwiecista tapeta”. Żaden z cyfrowo-sztucznych elementów – czegoś, co jest natychmiast widoczne dla każdego doświadczonego projektanta – nie pojawił się w jego odczycie. Odległości osadzania potwierdzają, że model nie ma wymiaru reprezentacyjnego odpowiadającego „estetyce generowanej przez AI”. Nie rozpoznaje on ani stylizacji, ani pochodzenia technicznego.
Ten przypadek jest szczególnie istotny, ponieważ wzór pochodzi z samego ekosystemu Adobe AI. Ujawnia to, że nawet gdy estetyka sztucznej inteligencji jest wyrazista, spójna i wizualnie rozpoznawalna, model multimodalny nie uznaje jej za semantycznie znaczącą. Cyfrowość obrazu staje się niewidoczna w przestrzeni osadzenia, która ponownie ciąży ku najczęściej występującym kategoriom komercyjnym.
W kontekście niniejszego badania tag „8k” nie odnosi się do żadnej mierzalnej rozdzielczości, lecz odzwierciedla komercyjny deskryptor internetowy powszechnie przypisywany tapetom kwiatowym i bezszwowym wzorom, ujawniając, jak modele multimodalne dziedziczą słownictwo oparte na SEO, zamiast analizować właściwości artystyczne lub techniczne.
Pętla echa semantycznego
Koncepcja echa semantycznego powstała jako sposób opisu rekurencyjnej relacji między modelami sztucznej inteligencji, danymi internetowymi i praktykami artystycznymi, z którymi coraz częściej się one przecinają. Odnosi się ona do stopniowej konwergencji znaczeń, która zachodzi, gdy modele uczą się na podstawie danych wyjściowych, na które miały wpływ. Z czasem tworzy to zamknięte środowisko semantyczne, w którym niuanse, różnorodność stylistyczna i intencja estetyczna są stopniowo kompresowane. Echo semantyczne zachowuje się podobnie do zniekształceń pamięci w ludzkim poznaniu: informacje powtarzane w tej samej formie stają się z czasem bardziej skompresowane, pewniejsze i mniej zniuansowane. Chociaż techniczne słownictwo opisujące to zjawisko obejmuje takie terminy, jak załamanie się modelu czy dryf sprzężenia zwrotnego, sedno problemu ma charakter kulturowy, a nie czysto obliczeniowy: przestrzeń reprezentacyjna modelu jest kształtowana nie przez mnogość kultury wizualnej, lecz przez statystyczną presję jego własnych, wcześniejszych interpretacji.
U podstaw tej pętli leży natura danych internetowych. Ekosystem obrazów online jest produktem ludzkich konwencji, selekcji i wygody. Opisy są zazwyczaj funkcjonalne, zorientowane na produkt i zoptymalizowane pod kątem widoczności, a nie dokładności. Rzadko odwołują się do stylu artystycznego, medium, narracji lub kontekstu historycznego. Gdy model taki jak OpenCLIP trenuje na tym materiale, jego osie semantyczne odzwierciedlają te konwencje. Nie ma on wymiaru dla stylu, ponieważ styl nie jest spójnie obecny w danych; nie ma wymiaru dla intencji estetycznej, ponieważ intencja nie pozostawia śladu tekstowego, którego model kontrastowy mógłby wiarygodnie się nauczyć.

Pętla zaciska się jeszcze bardziej, gdy obrazy generowane przez sztuczną inteligencję zaczynają krążyć w sieci. Modele generatywne generują obrazy ukształtowane przez tę samą przestrzeń semantyczną, której nauczyły się modele rozpoznawania, a obrazy te mieszają się z treściami tworzonymi przez ludzi w wyszukiwarkach, na platformach handlowych i w mediach społecznościowych. Gdy nowe modele trenują na tym hybrydowym zbiorze danych, przyswajają mieszaninę, w której wpływ wcześniejszych modeli jest już osadzony.
Rezultatem jest powolne, ale stałe zawężanie znaczenia: mniej niuansów stylistycznych, mniej kategorii z długim ogonem i rosnąca dominacja deskryptorów, które są częste, ważne komercyjnie i łatwe do wykrycia przez model. Ten rekurencyjny system wpływa na sposób, w jaki sztuczna inteligencja odczytuje dzieła artystyczne. Moje własne wyniki wyraźnie to ilustrują. Wczesne wersje CLIP próbowały nazwać styl, aczkolwiek niekonsekwentnie.
Zaktualizowana wersja OpenCLIP nie traktuje stylu jako kategorii semantycznej wartej przewidywania. Zachowuje się tak, jakby styl nie miał żadnej wagi reprezentacyjnej. Zamiast tego preferuje niewielki zestaw kategorii powiązanych z handlem internetowym: wzór, kwiaty, tapeta, bezszwowość, bajka. Pole opisowe modelu skupia się na tym, co jest obfite i satysfakcjonujące w danych, a nie na tym, co jest znaczące w praktyce artystycznej.
Analiza osadzania uwidacznia ten dryf. Profesjonalne tagi, które przypisuję do moich prac, skupiają się wokół intencji stylistycznej, tonu narracji i decyzji wizualnych – elementów, które należą do procesu twórczego, a nie są jedynie jego powierzchownym rezultatem. Natomiast tagi OpenCLIP są rozproszone wzdłuż osi komercyjnych. Semantyczne tarcie między tymi dwoma słownikami rośnie z każdą nową wersją modelu, co sugeruje, że model nie poprawia swojego rozumienia sztuki, ale zmniejsza złożoność swojej przestrzeni interpretacyjnej. To właśnie sprawia, że Echo Semantyczne jest czymś więcej niż metaforą. Jest to strukturalna cecha obecnego sposobu ewolucji wielkoskalowych systemów multimodalnych. Gdy światopogląd modelu powraca do danych treningowych, pole opisowe staje się coraz bardziej płaskie. Sztuczna inteligencja wydaje się pewna siebie, ale jej pewność siebie opiera się na wąskim paśmie kategorii, które dominują we współczesnej gospodarce obrazowej. Styl, technika i intencja pozostają poza tą logiką, ponieważ nie są nagradzane przez cykl.
Zrozumienie tej zamkniętej pętli jest niezbędne do wyobrażenia sobie alternatyw. Jeśli modele trenowane na niekurowanych danych internetowych nieuchronnie zmierzają w kierunku konkretnych deskryptorów komercyjnych, to każda próba zachowania stylistycznych niuansów musi rozpocząć się od różnych form kuratorowania danych — form, które angażują artystów, projektantów i ramy interpretacyjne, które kierują ludzką kulturą wizualną. Ostatnia część niniejszego raportu analizuje, jak mogłaby wyglądać taka alternatywa i jak zbiory danych tworzone przez artystów mogłyby zmienić przyszłość multimodalnych osadzeń.
W kierunku przyszłych modeli wizualnych
Wyniki tego badania sugerują, że ograniczenia zaobserwowane w interpretacji OpenCLIP w zakresie projektowania wzorów powierzchniowych nie są jedynie ograniczeniami technicznymi, ale symptomami głębszego problemu strukturalnego: modele multimodalne uczą się na podstawie danych zgromadzonych w skali internetowej, które nie doceniają stylu, techniki i intencji estetycznej. Jeśli kategorie te mają pozostać częścią algorytmicznego słownika kolejnej dekady, przyszłość graficznej sztucznej inteligencji będzie wymagała innego źródła semantycznego ugruntowania, ukształtowanego nie tylko przez logikę SEO, ale także przez wiedzę artystyczną. Obiecującym kierunkiem byłyby zbiory danych, w których ilustratorzy i projektanci formułowaliby własne intencje stylistyczne, metody produkcji i niuanse wizualne, tworząc bazę wiedzy przywracającą znaczenie tam, gdzie obecne modele je spłaszczają. Taka zmiana nie tylko zmniejszyłaby dryf semantyczny udokumentowany w niniejszym raporcie, ale także zapewniłaby, że narzędzia sztucznej inteligencji ewoluowałyby w dialogu z kulturowym, technicznym i wyobrażeniowym wymiarem ludzkiej praktyki twórczej. Zamiast zastępować osąd artystyczny, systemy te mogłyby zostać wyszkolone w jego rozpoznawaniu i zachowywaniu, tworząc bardziej zrównoważoną relację między widzeniem maszynowym a językami wizualnymi, które artyści rozwijają od wieków.
Wnioski — nowe spojrzenie na znaczenie w erze graficznej sztucznej inteligencji
Badanie „AI vs Brush” pokazuje, że gdy dzieło artystyczne wkracza w multimodalną przestrzeń osadzenia, nie jest po prostu tłumaczone – jest transformowane. Styl, technika i intencja, które stanowią kręgosłup profesjonalnej ilustracji i projektowania wzorów powierzchniowych, są stopniowo usuwane, zastępowane wąskim słownictwem ukształtowanym przez statystyczne nawyki internetu. Zaktualizowany model OpenCLIP nie myli tych kategorii; nie postrzega ich już jako znaczących. Ta zmiana ujawnia szerszą dynamikę kulturową: w miarę jak systemy AI coraz częściej uczą się z generowanych przez AI obrazów i deskryptorów zoptymalizowanych pod kątem SEO, ich krajobraz semantyczny staje się coraz bardziej jednolity, komercyjny i zorientowany na powierzchnię.
Jednak badanie pokazuje również, że ten dryf nie jest nieunikniony. Analizując tarcie między interpretacjami ludzkimi i maszynowymi, możemy zmapować, gdzie znaczenie zanika, gdzie niuanse przetrwają i gdzie przyszłe systemy mogą być kierowane inaczej. Zniknięcie stylu ze słownika modelu to nie tylko odkrycie techniczne – to zaproszenie do ponownego przemyślenia, jak chcemy, aby modele wizualne odnosiły się do praktyki artystycznej.
Dla artystów wnoszenie swojego doświadczenia do wielkoskalowych systemów AI nie oznacza oddawania wiedzy, ale strategiczną okazję do uzyskania wpływu na sposób kodowania znaczenia wizualnego w przyszłych modelach – umożliwiając tworzenie narzędzi, które lepiej rozumieją styl i technikę, tworząc nowe role zawodowe, takie jak kurator zbiorów danych czy konsultant ds. kreatywnej AI, wzmacniając ochronę i rozpoznawalność poszczególnych stylów artystycznych oraz zapewniając, że kolejna generacja graficznej AI będzie rozwijać się w autentycznym dialogu z ludzką kreatywnością, a nie dryfować w kierunku komercyjnego uproszczenia.
Jeśli AI ma odegrać znaczącą rolę w przyszłości projektowania, musi opierać się na wartościach i interpretacjach osób, które na co dzień pracują z językiem wizualnym. Niniejszy raport sugeruje, że droga naprzód nie leży w opieraniu się zmianom technologicznym, ale w zapewnieniu, że sektor kreatywny aktywnie przyczyni się do tworzenia semantycznych fundamentów, na których zbudowana zostanie kolejna generacja modeli.
Jeśli jesteś artystą, badaczem lub członkiem zespołu pracującego nad systemami sztucznej inteligencji opartymi na osadzaniu lub multimodalnych systemach i chciałbyś współpracować przy testowaniu, analizowaniu lub rozszerzaniu tych badań, gorąco zapraszam do nawiązania kontaktu i wspólnego odkrywania kolejnych etapów tej pracy.
